Disclosure: Some links on this page are affiliate links. We may earn a commission if you make a purchase through them, at no additional cost to you.
Om du letar efter de bästa proxyerna för webbskrapning är Shifter ett kraftfullt val med över 30 miljoner IP-adresser, obegränsad bandbredd och inbyggda scraping-API:er för storskalig datainsamling. För flexibla upplägg och skalbar scraping erbjuder SimplyNode pålitliga residential- och mobila proxyer med stark prestanda och global täckning. För avancerad scraping-infrastruktur och automatiseringsverktyg utmärker sig Decodo (Smartproxy) med sin stora IP-pool, höga success rates och utvecklarvänliga API:er.
Verktyg för webbskrapning är avgörande för att effektivt och i stor skala extrahera värdefull data från webbplatser. Oavsett om du övervakar konkurrenters priser, samlar in insikter från sociala medier eller bygger forskningsdataset, automatiserar rätt verktyg komplexa uppgifter och sparar otaliga timmar av manuellt arbete. Från scraping-API:er och proxy-drivna plattformar till ramverk för webbläsarautomation och no-code-verktyg – den här guiden jämför de bästa alternativen på marknaden idag.
De starkaste verktygen går längre än grundläggande extraktion. Tänk JavaScript-rendering, Captcha-lösning, IP-rotation, webbläsarfingeravtryck (fingerprinting), återförsök, schemaläggning och ren API-leverans in i din BI- eller ETL-stack. Nedan bryter vi ner de främsta alternativen utifrån idealiskt användningsfall, styrkor, kompromisser och prissättningsprofil.
Snabb jämförelse (översikt)
Kärnkriterier: JS-rendering • Captcha-lösning • Smart rotation • API/SDK • No-code • Schemaläggning • Prissättning
| Verktyg | Bäst för | Utmärkande funktioner | Startpris* | Skalning |
|---|---|---|---|---|
| Shifter.io | Scraping API + proxy-backad datainsamling | JS-renderingCaptchaIP-rotationSERP API | Nivåbaserat | SMB → Enterprise |
| SimplyNode | Proxy-först scraping-upplägg | Residential proxiesGeo-targetingStor pool | Användningsbaserat | Indie → Enterprise |
| Decodo | Pålitlig extraktion + massiva proxies | 40M+ proxiesJS/APICaptchaRå HTML | $50/mån | SMB → Enterprise |
| Oxylabs | Global täckning + betala per resultat | 10M+ proxiesAuto-återförsökJS-rendering | $49/mån | SMB → Enterprise |
| Bright Data | No-code + djupa SDK:er | DatasetsETL-kopplingarProxy-typer | Nivåer / offert | SMB → Enterprise |
| Apify | Actors, integrationer & no-code-körningar | Zapier/AirbyteMarketplaceRotation | Gratisnivå finns | Indie → Enterprise |
| ScraperAPI | Utvecklare som vill ha enkla endpoints | Anti-botJS-renderingObegränsad bandbredd | $49/mån | SMB → Enterprise |
| ZenRows | Skyddade sajter och anti-bot-bypass | JS-renderingCaptchaProxy-rotation | Från $69/mån | SMB → Enterprise |
| Octoparse | No-code moln + desktop-scraping | Visuell byggareSchemaläggningMolnkörningar | Gratisnivå; betalda planer | Indie → SMB |
| Scrapy | Maximal kontroll för Python-team | Open sourcePipelinesUtbyggbart | Gratis | SMB → Enterprise |
| Playwright | Webbläsarautomation för JS-tunga mål | Chromium/Firefox/WebKitHeadlessSPA-stöd | Gratis | Indie → Enterprise |
Bästa verktygen för webbskrapning — djupgående recensioner

Shifter.io
Shifter.io tar förstaplatsen om du vill ha en proxy-backad scrapingplattform som redan innehåller den nyckelinfrastruktur som krävs för att samla in data i skala. Deras Web Scraping API är byggt för att minska setup-friktion genom att paketera automatisk proxy-rotation, Captcha-lösning och JavaScript-rendering med riktig webbläsare i ett och samma flöde. Det är särskilt attraktivt för team som inte vill sy ihop separata leverantörer för rendering, proxies och request-leverans.
En annan styrka är att Shifter är bredare än en enda scraping-endpoint. De erbjuder även relaterade tjänster som SERP API och residential proxy-infrastruktur, vilket gör dem användbara för företag som kör flera insamlingsflöden över sök, e-handel och platskänsliga mål.
- Scraping API med inbyggd rotation, JS-rendering och Captcha-hantering
- Bra för team som vill ha färre rörliga delar
- Brett produktutbud kring scraping- och proxy-use cases
- Passar både direkt extraktion och insamling av sökresultat
- Mindre “mindshare” i communityn än vissa större scraping-varumärken
- Prissättning är inte lika direkt jämförbar som enkla fasta planer

SimplyNode
SimplyNode bör ses som en proxy-first plattform för scraping snarare än en traditionell allt-i-ett-svit för scraping. Det är exakt därför de förtjänar en hög placering i listan. Om dina flöden är beroende av stabila residential IP:n, platsinriktning och lägre blockfrekvens, ger SimplyNode dig infrastrukturlagret som behövs för att köra din egen scraping-stack mer pålitligt.
Det är särskilt användbart för operatörer som redan har parsers, scripts eller webbläsarautomation på plats och främst behöver högkvalitativ proxy-access för webbskrapning, prisövervakning, SERP-insamling och geo-specifik extraktion.
- Stark match för proxy-baserade scraping-arkitekturer
- Residential täckning för lägre blockfrekvens
- Flexibelt för egna stackar med Scrapy, Playwright eller privata scripts
- Användbart för geo-targeted och marknadsspecifik insamling
- Mindre “plug-and-play” än API-first leverantörer
- Kräver mer setup på användarsidan om du vill ha en komplett pipeline
Decodo
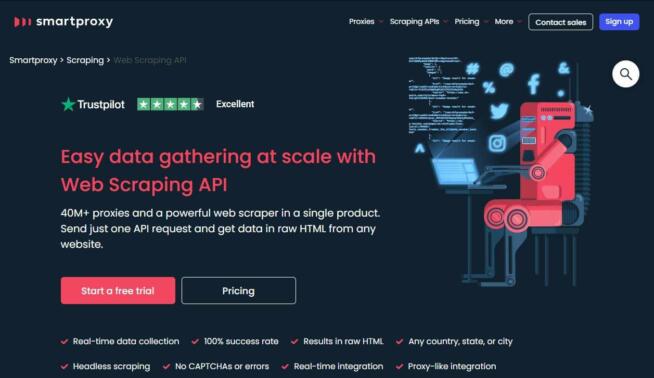
Decodo är en pålitlig webbskrapningsstack som kombinerar ett stort proxynätverk med enkel datainsamling. Med tillgång till 40M+ proxies minimeras IP-blockering och geo-targeting stöds, samtidigt som rå HTML levereras till team som föredrar att köra egna parsers. Upplevelsen är medvetet enkel: konfigurera, peka mot målsidor och få färsk data.
- Stor, diversifierad proxypool med enkel integration
- Insamling i realtid; bred kompatibilitet med webbplatser
- Captcha-automation, API-requests, kontinuerlig leverans
- Flexibel prissättning; gratis provperiod för att validera passform
- Provperioden kunde vara längre för komplexa PoC:er
- Regional moms kan öka totalkostnaden
Oxylabs
Oxylabs erbjuder en bred proxy-footprint och scraping-API:er med pay-per-result-prissättning, där du bara betalar för lyckade extraktioner. Förvänta dig JS-rendering, geo-targeting på landsnivå, automatiska återförsök och färre Captchas. Passar team som vill ha global räckvidd utan att micromanage:a infrastruktur.
- Snabba svar; hög träffgrad på vanliga mål
- Betala för resultat — kostnaderna speglar utfallet
- Skrapning i realtid + granular geo-targeting
- Avancerade planer kan bli dyra för mindre team
- Ingen dedikerad AM på lägre nivåer
Bright Data
Tidigare Luminati. Bright Data kombinerar no-code-flöden med djupa utvecklar-primitives. De glänser när du behöver automatiserade workflows, ett brett spektrum av datakällor, avancerade filter och integrationer in i BI-pipelines. Output kan vara API, HTML och CSV.
- Stora proxy-alternativ + färdiga datasets
- No-code + fulla SDK:er för hybridteam
- Stark match för storskalig insamling och leverans
- Rik funktionalitet ger en brantare inlärningskurva
- Kan vara overkill för mindre, engångs-scrapingjobb
Apify
Apify är en plattform för att bygga och köra actors — återanvändbara enheter för scraping och automation. Välj från community-store eller bygg egna i Node eller Python; koppla in via Zapier eller Airbyte. IP-rotation, Captcha-lösning och flera proxy-typer ger dig komponenterna som behövs för tuffare mål.
- Stark marketplace med färdiga actors
- Automation-vänligt; ETL-integrationer
- Flexibelt för både no-code-användare och utvecklare
- Tät UI kan kännas överväldigande i början
- Supportrespons är medel på lägre nivåer
ScraperAPI
ScraperAPI är utvecklarcentrerat: mata in en URL i en endpoint och få tillbaka ren HTML eller JSON. Det stödjer cURL, Python, Node, PHP, Ruby och Java. Captcha-automation, smart rotation och JS-rendering hanteras åt dig. Det är ett av de enklaste sätten att göra en enkel request-workflow till en produktionsklar scraping-setup.
- Snabb onboarding; minimala kodändringar
- Obegränsad bandbredd; geo-targeting på högre nivåer
- Starka concurrency-alternativ på businessplaner
- Lägre nivåer kan begränsa credits eller trådar
- Vissa anti-bot-mönster kräver fortfarande retry-logik på användarsidan
ZenRows
ZenRows är byggt för webbplatser med tyngre anti-bot-försvar. Det kombinerar automatisk JavaScript-rendering, Captcha-lösning, dynamisk proxy-rotation och anti-bot-bypass i en ren API-upplevelse. Om dina mål inkluderar moderna e-handelssajter, SERP:ar och skyddade sidor är ZenRows ett av de starkaste mid-market-alternativen.
- Starka anti-bot-förmågor för svåra mål
- Bra balans mellan kraft och enkelhet
- Fungerar väl för API-baserade scraping-pipelines
- Avancerad användning kan bli dyr i skala
- Mindre lämpligt för användare som vill ha ett visuellt no-code-flöde
Octoparse
Octoparse är no-code-valet för användare som vill ha en visuell scraping-byggare med molnkörning. Det hanterar dynamiska sajter, infinite scroll, schemaläggning och teamvänliga workflows bättre än många klassiska desktop-scrapers. För analytiker, marknadsförare och operations-team som föredrar GUI framför kod är det fortfarande ett av de bästa valen.
- Nybörjarvänligt gränssnitt med molnkörning
- Praktiskt för team som vill ha återkommande körningar utan kod
- Stöd för schemalagda jobb och större workflows
- Avancerade planer blir dyra snabbare än vissa API-verktyg
- Mindre flexibelt än code-first ramverk för komplex logik
Scrapy
Scrapy är ett open-source Python-ramverk för proffs som vill ha maximal kontroll. Det är starkt i storskaliga pipelines, med middleware för headers, cookies, paginering och request-orkestrering. Om du vill ha ett mycket anpassningsbart system som passar din data engineering-stack är Scrapy fortfarande en av de bästa grunderna som finns.
- Gratis, moget och extremt anpassningsbart
- Starkt ekosystem och produktionsflexibilitet
- Utmärkt för strukturerade pipelines och egen lagring
- CLI- och Python-kunskap krävs
- Du måste hantera egen infrastruktur och anti-bot-stack
Playwright
Playwright är ett modernt ramverk för webbläsarautomation från Microsoft och ett av de bästa verktygen för att skrapa SPA:er och andra JavaScript-tunga webbplatser. Det styr Chromium, Firefox och WebKit, stödjer autentiseringsflöden, multi-tab-sessioner, realistiskt webbläsarbeteende och detaljerad interaktionslogik. För avancerade användare är det ofta det bästa valet när ren HTTP-skrapning inte räcker.
- Utmärkt för moderna frontend-tunga webbplatser
- Stöd för flera språk och webbläsarmotorer
- Idealisk partner till proxies och externa Captcha-lösare
- Code-first; inte designat för no-code-användare
- Du hanterar själv infra, återförsök och skalning
Så väljer du rätt verktyg (beslutsramverk)
- Teamets kompetens & ägarskap. No-code-verktyg som Octoparse är idealiska för analytiker och ops-team. Low-code och plattformslösningar som Apify passar blandade team. Ramverk som Scrapy och Playwright är bäst för engineering-tunga upplägg.
- Målsajtens anti-bot-nivå. Om sajter är JS-tunga och hårt bevakade, prioritera rendering + rotation + Captcha med leverantörer som Shifter.io, Oxylabs, Bright Data, ZenRows och ScraperAPI.
- Datavolym & aktualitet. För kontinuerlig insamling skalar API:er och proxy-backade tjänster bättre. För kontrollerade, repeterbara jobb kan actor-baserade eller no-code-workflows vara enklare att underhålla.
- Budget & förutsägbarhet. Open-source minskar mjukvarukostnad men ökar engineering-overhead. Managerade API:er kostar mer direkt men minskar operativt arbete och time-to-value.
- Infrastruktur vs. utfall. Om du främst behöver IP-lagret passar SimplyNode och Decodo bra. Om du vill få extraktionen levererad är verktyg som Shifter.io, Oxylabs, Apify och ScraperAPI mer kompletta.
- Styrning & compliance. Välj leverantörer med tydlig dokumentation och operativa kontroller. Implementera caching, throttling, rate limits och dataminimering som standard.
Playbooks: Vanliga användningsrecept
Prisövervakning för e-handel (dagligen)
- Börja med Shifter.io, Oxylabs eller ScraperAPI för stabil insamling av produktsidor.
- Aktivera rotation + JS-rendering för dynamiska sidor och platskänsliga varianter.
- Lagra strukturerad JSON i ditt data warehouse och trigga larm när prisdeltan överstiger din tröskel.
Innehållsövervakning av konkurrenter (veckovis)
- Använd Apify eller ZenRows för repeterbar skrapning av bloggar, kategorier och kataloger.
- Normalisera titlar, taggar och publiceringsdatum; spara HTML-snapshots för audit trails.
- Skicka veckorapporter till Slack, e-post eller din interna dashboard.
Storskaliga skräddarsydda pipelines
- Använd Scrapy för crawl-logik med hög volym och item pipelines.
- Lägg till SimplyNode eller ett annat proxy-lager för rotation och geo-specifik access.
- Använd köer, återförsök och molnlagring för feltolerans och downstream processing.
JavaScript-tunga webbplatser och inloggade flöden
- Använd Playwright för autentiserade sessioner, SPA:er och dynamiska frontends.
- Kombinera med proxy-rotation och Captcha-lösning vid behov.
- Exportera rena strukturerade fält i stället för att bara spara rå HTML.
No-code-extraktion för business-team
- Använd Octoparse om du vill ha visuell setup och molnschemaläggning.
- Prototypa mål snabbt, validera output-kvalitet och skala sedan till managerade jobb.
- Lyft stabila workflows till en API-baserad stack om throughput eller anti-bot-svårighet ökar.